Home / AI GPUs / AMD Radeon RX 7800 XT 16 GB
AMD Radeon RX 7800 XT 16 GB
16 GB GDDR6 advertised VRAM. Usable memory for calculations is 90% of advertised capacity. This page is the chip + VRAM entity — not a single cooler SKU.
No fresh matched Amazon price is currently available for this canonical GPU.
What can I runCompare this GPUValue explorerFind a GPU for a model
What AI models can it run?
Calculated memory fit for catalog models on this chip. Defaults are Q4 and 8K when you do not change the controls. This is not a speed ranking.
- GPU
- AMD Radeon RX 7800 XT 16 GB · 16 GB advertised
- Usable VRAM
- 14.4 GB (advertised × 0.90)
- Quantization
- Q4 (default for this form)
- Context
- 8K (default for this form)
53 of 82 catalog models calculate as a full VRAM fit under these assumptions.
Runs fully in GPU VRAM
53 models at the selected quantization and context. Memory fit only — not a speed ranking.
StarCoder2 15B
- Quantization
- Q4
- Context
- 8K
- Required VRAM
- 11.5 GB
- Usable GPU VRAM
- 14.4 GB
- VRAM headroom
- 2.9 GB leftover after the calculated requirement
- Fit
- Fits Runs fully in GPU VRAM
At 8K: FP16 Offload BF16 Offload Q8 Offload Q6 Offload Q5 Fits Q4 Fits Q3 Fits
Q4: 16K Fits 2K Fits 4K Fits 8K Fits
Qwen3 14B
- Quantization
- Q4
- Context
- 8K
- Required VRAM
- 11.4 GB
- Usable GPU VRAM
- 14.4 GB
- VRAM headroom
- 3.0 GB leftover after the calculated requirement
- Fit
- Fits Runs fully in GPU VRAM
At 8K: FP16 Offload BF16 Offload Q8 Offload Q6 Limited context Q5 Fits Q4 Fits Q3 Fits
Q4: 16K Fits 2K Fits 32K Limited context 4K Fits 40K Limited context 8K Fits
DeepSeek R1 Distill Qwen 14B
- Quantization
- Q4
- Context
- 8K
- Required VRAM
- 11.6 GB
- Usable GPU VRAM
- 14.4 GB
- VRAM headroom
- 2.8 GB leftover after the calculated requirement
- Fit
- Fits Runs fully in GPU VRAM
At 8K: FP16 Offload BF16 Offload Q8 Offload Q6 Limited context Q5 Fits Q4 Fits Q3 Fits
Q4: 128K Limited context 16K Fits 2K Fits 32K Limited context 4K Fits 64K Limited context 8K Fits
Phi-4
- Quantization
- Q4
- Context
- 8K
- Required VRAM
- 11.6 GB
- Usable GPU VRAM
- 14.4 GB
- VRAM headroom
- 2.8 GB leftover after the calculated requirement
- Fit
- Fits Runs fully in GPU VRAM
At 8K: FP16 Offload BF16 Offload Q8 Offload Q6 Limited context Q5 Fits Q4 Fits Q3 Fits
Q4: 16K Fits 2K Fits 4K Fits 8K Fits
Qwen2.5 14B Instruct
- Quantization
- Q4
- Context
- 8K
- Required VRAM
- 11.6 GB
- Usable GPU VRAM
- 14.4 GB
- VRAM headroom
- 2.8 GB leftover after the calculated requirement
- Fit
- Fits Runs fully in GPU VRAM
At 8K: FP16 Offload BF16 Offload Q8 Offload Q6 Limited context Q5 Fits Q4 Fits Q3 Fits
Q4: 16K Fits 2K Fits 32K Limited context 4K Fits 8K Fits
Phi-4 Reasoning
- Quantization
- Q4
- Context
- 8K
- Required VRAM
- 11.6 GB
- Usable GPU VRAM
- 14.4 GB
- VRAM headroom
- 2.8 GB leftover after the calculated requirement
- Fit
- Fits Runs fully in GPU VRAM
At 8K: FP16 Offload BF16 Offload Q8 Offload Q6 Limited context Q5 Fits Q4 Fits Q3 Fits
Q4: 16K Fits 2K Fits 32K Limited context 4K Fits 8K Fits
Phi-3 Medium 128K Instruct
- Quantization
- Q4
- Context
- 8K
- Required VRAM
- 11.2 GB
- Usable GPU VRAM
- 14.4 GB
- VRAM headroom
- 3.2 GB leftover after the calculated requirement
- Fit
- Fits Runs fully in GPU VRAM
At 8K: FP16 Offload BF16 Offload Q8 Offload Q6 Limited context Q5 Fits Q4 Fits Q3 Fits
Q4: 128K Limited context 16K Fits 2K Fits 32K Limited context 4K Fits 64K Limited context 8K Fits
Mistral Nemo 12B Instruct
- Quantization
- Q4
- Context
- 8K
- Required VRAM
- 9.7 GB
- Usable GPU VRAM
- 14.4 GB
- VRAM headroom
- 4.7 GB leftover after the calculated requirement
- Fit
- Fits Runs fully in GPU VRAM
At 8K: FP16 Offload BF16 Offload Q8 Offload Q6 Fits Q5 Fits Q4 Fits Q3 Fits
Q4: 128K Limited context 16K Fits 2K Fits 32K Fits 4K Fits 64K Limited context 8K Fits
Gemma 3 12B Instruct
- Quantization
- Q4
- Context
- 8K
- Required VRAM
- 11.5 GB
- Usable GPU VRAM
- 14.4 GB
- VRAM headroom
- 2.9 GB leftover after the calculated requirement
- Fit
- Fits Runs fully in GPU VRAM
At 8K: FP16 Offload BF16 Offload Q8 Offload Q6 Limited context Q5 Fits Q4 Fits Q3 Fits
Q4: 128K Limited context 16K Limited context 2K Fits 32K Limited context 4K Fits 64K Limited context 8K Fits
Gemma 4 12B Instruct
- Quantization
- Q4
- Context
- 8K
- Required VRAM
- 11.3 GB
- Usable GPU VRAM
- 14.4 GB
- VRAM headroom
- 3.1 GB leftover after the calculated requirement
- Fit
- Fits Runs fully in GPU VRAM
At 8K: FP16 Offload BF16 Offload Q8 Offload Q6 Limited context Q5 Fits Q4 Fits Q3 Fits
Q4: 128K Limited context 16K Fits 2K Fits 256K Limited context 32K Limited context 4K Fits 64K Limited context 8K Fits
Falcon 3 10B Instruct
- Quantization
- Q4
- Context
- 8K
- Required VRAM
- 8.5 GB
- Usable GPU VRAM
- 14.4 GB
- VRAM headroom
- 5.9 GB leftover after the calculated requirement
- Fit
- Fits Runs fully in GPU VRAM
At 8K: FP16 Offload BF16 Offload Q8 Fits Q6 Fits Q5 Fits Q4 Fits Q3 Fits
Q4: 16K Fits 2K Fits 32K Fits 4K Fits 8K Fits
GLM-4-9B-0414
- Quantization
- Q4
- Context
- 8K
- Required VRAM
- 7.0 GB
- Usable GPU VRAM
- 14.4 GB
- VRAM headroom
- 7.4 GB leftover after the calculated requirement
- Fit
- Fits Runs fully in GPU VRAM
At 8K: FP16 Offload BF16 Offload Q8 Fits Q6 Fits Q5 Fits Q4 Fits Q3 Fits
Q4: 16K Fits 2K Fits 32K Fits 4K Fits 8K Fits
GLM-4 9B Chat
- Quantization
- Q4
- Context
- 8K
- Required VRAM
- 11.7 GB
- Usable GPU VRAM
- 14.4 GB
- VRAM headroom
- 2.7 GB leftover after the calculated requirement
- Fit
- Fits Runs fully in GPU VRAM
At 8K: FP16 Offload BF16 Offload Q8 Limited context Q6 Fits Q5 Fits Q4 Fits Q3 Fits
Q4: 128K Limited context 16K Limited context 2K Fits 32K Limited context 4K Fits 64K Limited context 8K Fits
Gemma 2 9B Instruct
- Quantization
- Q4
- Context
- 8K
- Required VRAM
- 9.2 GB
- Usable GPU VRAM
- 14.4 GB
- VRAM headroom
- 5.2 GB leftover after the calculated requirement
- Fit
- Fits Runs fully in GPU VRAM
At 8K: FP16 Offload BF16 Offload Q8 Fits Q6 Fits Q5 Fits Q4 Fits Q3 Fits
Q4: 2K Fits 4K Fits 8K Fits
Qwen3 8B
- Quantization
- Q4
- Context
- 8K
- Required VRAM
- 7.1 GB
- Usable GPU VRAM
- 14.4 GB
- VRAM headroom
- 7.3 GB leftover after the calculated requirement
- Fit
- Fits Runs fully in GPU VRAM
At 8K: FP16 Offload BF16 Offload Q8 Fits Q6 Fits Q5 Fits Q4 Fits Q3 Fits
Q4: 16K Fits 2K Fits 32K Fits 4K Fits 40K Fits 8K Fits
DeepSeek R1 Distill Llama 8B
- Quantization
- Q4
- Context
- 8K
- Required VRAM
- 6.8 GB
- Usable GPU VRAM
- 14.4 GB
- VRAM headroom
- 7.6 GB leftover after the calculated requirement
- Fit
- Fits Runs fully in GPU VRAM
At 8K: FP16 Offload BF16 Offload Q8 Fits Q6 Fits Q5 Fits Q4 Fits Q3 Fits
Q4: 128K Limited context 16K Fits 2K Fits 32K Fits 4K Fits 64K Fits 8K Fits
Hermes 3 Llama 3.1 8B
- Quantization
- Q4
- Context
- 8K
- Required VRAM
- 6.8 GB
- Usable GPU VRAM
- 14.4 GB
- VRAM headroom
- 7.6 GB leftover after the calculated requirement
- Fit
- Fits Runs fully in GPU VRAM
At 8K: FP16 Offload BF16 Offload Q8 Fits Q6 Fits Q5 Fits Q4 Fits Q3 Fits
Q4: 128K Limited context 16K Fits 2K Fits 32K Fits 4K Fits 64K Fits 8K Fits
Llama 3.1 8B Instruct
- Quantization
- Q4
- Context
- 8K
- Required VRAM
- 6.8 GB
- Usable GPU VRAM
- 14.4 GB
- VRAM headroom
- 7.6 GB leftover after the calculated requirement
- Fit
- Fits Runs fully in GPU VRAM
At 8K: FP16 Offload BF16 Offload Q8 Fits Q6 Fits Q5 Fits Q4 Fits Q3 Fits
Q4: 128K Limited context 16K Fits 2K Fits 32K Fits 4K Fits 64K Fits 8K Fits
Llama 3 8B Instruct
- Quantization
- Q4
- Context
- 8K
- Required VRAM
- 6.8 GB
- Usable GPU VRAM
- 14.4 GB
- VRAM headroom
- 7.6 GB leftover after the calculated requirement
- Fit
- Fits Runs fully in GPU VRAM
At 8K: FP16 Offload BF16 Offload Q8 Fits Q6 Fits Q5 Fits Q4 Fits Q3 Fits
Q4: 2K Fits 4K Fits 8K Fits
Ministral 8B Instruct
- Quantization
- Q4
- Context
- 8K
- Required VRAM
- 7.0 GB
- Usable GPU VRAM
- 14.4 GB
- VRAM headroom
- 7.4 GB leftover after the calculated requirement
- Fit
- Fits Runs fully in GPU VRAM
At 8K: FP16 Offload BF16 Offload Q8 Fits Q6 Fits Q5 Fits Q4 Fits Q3 Fits
Q4: 16K Fits 2K Fits 32K Fits 4K Fits 8K Fits
Fits with a shorter context
1 model at the selected quantization and context. Memory fit only — not a speed ranking.
Code Llama 13B Instruct
- Quantization
- Q4
- Context
- 8K
- Required VRAM
- 15.2 GB
- Usable GPU VRAM
- 14.4 GB
- VRAM headroom
- 0.8 GB over usable VRAM
- Fit
- Limited context Fits with a shorter context
At 8K: FP16 Offload BF16 Offload Q8 Offload Q6 Limited context Q5 Limited context Q4 Limited context Q3 Fits
Q4: 16K Limited context 2K Fits 4K Fits 8K Limited context
Requires CPU/RAM offload
18 models at the selected quantization and context. Memory fit only — not a speed ranking.
Mixtral 8x7B Instruct
- Quantization
- Q4
- Context
- 8K
- Required VRAM
- 31.3 GB
- Usable GPU VRAM
- 14.4 GB
- VRAM headroom
- 16.9 GB over usable VRAM
- Fit
- Offload Requires CPU/RAM offload
At 8K: FP16 No BF16 No Q8 No Q6 No Q5 Offload Q4 Offload Q3 Offload
Q4: 16K Offload 2K Offload 32K Offload 4K Offload 8K Offload
Code Llama 34B Instruct
- Quantization
- Q4
- Context
- 8K
- Required VRAM
- 23.6 GB
- Usable GPU VRAM
- 14.4 GB
- VRAM headroom
- 9.2 GB over usable VRAM
- Fit
- Offload Requires CPU/RAM offload
At 8K: FP16 No BF16 No Q8 No Q6 Offload Q5 Offload Q4 Offload Q3 Offload
Q4: 16K Offload 2K Offload 4K Offload 8K Offload
DeepSeek Coder 33B Instruct
- Quantization
- Q4
- Context
- 8K
- Required VRAM
- 23.8 GB
- Usable GPU VRAM
- 14.4 GB
- VRAM headroom
- 9.4 GB over usable VRAM
- Fit
- Offload Requires CPU/RAM offload
At 8K: FP16 No BF16 No Q8 Offload Q6 Offload Q5 Offload Q4 Offload Q3 Offload
Q4: 16K Offload 2K Offload 4K Offload 8K Offload
Qwen3 32B
- Quantization
- Q4
- Context
- 8K
- Required VRAM
- 23.5 GB
- Usable GPU VRAM
- 14.4 GB
- VRAM headroom
- 9.1 GB over usable VRAM
- Fit
- Offload Requires CPU/RAM offload
At 8K: FP16 No BF16 No Q8 Offload Q6 Offload Q5 Offload Q4 Offload Q3 Offload
Q4: 16K Offload 2K Offload 32K Offload 4K Offload 40K Offload 8K Offload
DeepSeek R1 Distill Qwen 32B
- Quantization
- Q4
- Context
- 8K
- Required VRAM
- 23.3 GB
- Usable GPU VRAM
- 14.4 GB
- VRAM headroom
- 8.9 GB over usable VRAM
- Fit
- Offload Requires CPU/RAM offload
At 8K: FP16 No BF16 No Q8 Offload Q6 Offload Q5 Offload Q4 Offload Q3 Offload
Q4: 128K Offload 16K Offload 2K Offload 32K Offload 4K Offload 64K Offload 8K Offload
Qwen2.5 32B Instruct
- Quantization
- Q4
- Context
- 8K
- Required VRAM
- 23.3 GB
- Usable GPU VRAM
- 14.4 GB
- VRAM headroom
- 8.9 GB over usable VRAM
- Fit
- Offload Requires CPU/RAM offload
At 8K: FP16 No BF16 No Q8 Offload Q6 Offload Q5 Offload Q4 Offload Q3 Offload
Q4: 16K Offload 2K Offload 32K Offload 4K Offload 8K Offload
Qwen2.5-Coder 32B Instruct
- Quantization
- Q4
- Context
- 8K
- Required VRAM
- 23.3 GB
- Usable GPU VRAM
- 14.4 GB
- VRAM headroom
- 8.9 GB over usable VRAM
- Fit
- Offload Requires CPU/RAM offload
At 8K: FP16 No BF16 No Q8 Offload Q6 Offload Q5 Offload Q4 Offload Q3 Offload
Q4: 16K Offload 2K Offload 32K Offload 4K Offload 8K Offload
QwQ 32B
- Quantization
- Q4
- Context
- 8K
- Required VRAM
- 23.3 GB
- Usable GPU VRAM
- 14.4 GB
- VRAM headroom
- 8.9 GB over usable VRAM
- Fit
- Offload Requires CPU/RAM offload
At 8K: FP16 No BF16 No Q8 Offload Q6 Offload Q5 Offload Q4 Offload Q3 Offload
Q4: 16K Offload 2K Offload 32K Offload 4K Offload 40K Offload 8K Offload
Gemma 4 31B Instruct
- Quantization
- Q4
- Context
- 8K
- Required VRAM
- 28.1 GB
- Usable GPU VRAM
- 14.4 GB
- VRAM headroom
- 13.7 GB over usable VRAM
- Fit
- Offload Requires CPU/RAM offload
At 8K: FP16 No BF16 No Q8 Offload Q6 Offload Q5 Offload Q4 Offload Q3 Offload
Q4: 128K Offload 16K Offload 2K Offload 256K Offload 32K Offload 4K Offload 64K Offload 8K Offload
Qwen3 30B-A3B
- Quantization
- Q4
- Context
- 8K
- Required VRAM
- 20.8 GB
- Usable GPU VRAM
- 14.4 GB
- VRAM headroom
- 6.4 GB over usable VRAM
- Fit
- Offload Requires CPU/RAM offload
At 8K: FP16 No BF16 No Q8 Offload Q6 Offload Q5 Offload Q4 Offload Q3 Offload
Q4: 16K Offload 2K Offload 32K Offload 4K Offload 40K Offload 8K Offload
Qwen3-Coder 30B-A3B Instruct
- Quantization
- Q4
- Context
- 8K
- Required VRAM
- 20.8 GB
- Usable GPU VRAM
- 14.4 GB
- VRAM headroom
- 6.4 GB over usable VRAM
- Fit
- Offload Requires CPU/RAM offload
At 8K: FP16 No BF16 No Q8 Offload Q6 Offload Q5 Offload Q4 Offload Q3 Offload
Q4: 128K Offload 16K Offload 2K Offload 256K Offload 32K Offload 4K Offload 64K Offload 8K Offload
Gemma 3 27B Instruct
- Quantization
- Q4
- Context
- 8K
- Required VRAM
- 22.0 GB
- Usable GPU VRAM
- 14.4 GB
- VRAM headroom
- 7.6 GB over usable VRAM
- Fit
- Offload Requires CPU/RAM offload
At 8K: FP16 No BF16 No Q8 Offload Q6 Offload Q5 Offload Q4 Offload Q3 Offload
Q4: 128K Offload 16K Offload 2K Offload 32K Offload 4K Offload 64K Offload 8K Offload
Gemma 2 27B Instruct
- Quantization
- Q4
- Context
- 8K
- Required VRAM
- 20.9 GB
- Usable GPU VRAM
- 14.4 GB
- VRAM headroom
- 6.5 GB over usable VRAM
- Fit
- Offload Requires CPU/RAM offload
At 8K: FP16 No BF16 No Q8 Offload Q6 Offload Q5 Offload Q4 Offload Q3 Offload
Q4: 2K Offload 4K Offload 8K Offload
Gemma 4 26B-A4B Instruct
- Quantization
- Q4
- Context
- 8K
- Required VRAM
- 19.4 GB
- Usable GPU VRAM
- 14.4 GB
- VRAM headroom
- 5.0 GB over usable VRAM
- Fit
- Offload Requires CPU/RAM offload
At 8K: FP16 No BF16 No Q8 Offload Q6 Offload Q5 Offload Q4 Offload Q3 Offload
Q4: 128K Offload 16K Offload 2K Offload 256K Offload 32K Offload 4K Offload 64K Offload 8K Offload
Mistral Small 3.2 24B Instruct
- Quantization
- Q4
- Context
- 8K
- Required VRAM
- 17.2 GB
- Usable GPU VRAM
- 14.4 GB
- VRAM headroom
- 2.8 GB over usable VRAM
- Fit
- Offload Requires CPU/RAM offload
At 8K: FP16 No BF16 No Q8 Offload Q6 Offload Q5 Offload Q4 Offload Q3 Fits
Q4: 128K Offload 16K Offload 2K Offload 32K Offload 4K Offload 64K Offload 8K Offload
Mistral Small 24B Instruct
- Quantization
- Q4
- Context
- 8K
- Required VRAM
- 17.0 GB
- Usable GPU VRAM
- 14.4 GB
- VRAM headroom
- 2.6 GB over usable VRAM
- Fit
- Offload Requires CPU/RAM offload
At 8K: FP16 No BF16 No Q8 Offload Q6 Offload Q5 Offload Q4 Offload Q3 Fits
Q4: 16K Offload 2K Offload 32K Offload 4K Offload 8K Offload
Magistral Small
- Quantization
- Q4
- Context
- 8K
- Required VRAM
- 16.9 GB
- Usable GPU VRAM
- 14.4 GB
- VRAM headroom
- 2.5 GB over usable VRAM
- Fit
- Offload Requires CPU/RAM offload
At 8K: FP16 No BF16 No Q8 Offload Q6 Offload Q5 Offload Q4 Offload Q3 Fits
Q4: 16K Offload 2K Offload 32K Offload 4K Offload 40K Offload 8K Offload
GPT-OSS 20B
- Quantization
- Q4
- Context
- 8K
- Required VRAM
- 14.7 GB
- Usable GPU VRAM
- 14.4 GB
- VRAM headroom
- 0.3 GB over usable VRAM
- Fit
- Offload Requires CPU/RAM offload
At 8K: FP16 No BF16 No Q8 Offload Q6 Offload Q5 Offload Q4 Offload Q3 Fits
Q4: 128K Offload 16K Offload 2K Offload 32K Offload 4K Offload 64K Offload 8K Offload
Does not fit
| Model | Required VRAM | Usable VRAM | Status |
|---|---|---|---|
| GLM-4.5 | 230.7 GB | 14.4 GB | No |
| Qwen3 235B-A22B | 151.2 GB | 14.4 GB | No |
| Mixtral 8x22B Instruct | 91.8 GB | 14.4 GB | No |
| GPT-OSS 120B | 75.5 GB | 14.4 GB | No |
| GLM-4.5 Air | 72.2 GB | 14.4 GB | No |
| Qwen2.5 72B Instruct | 49.3 GB | 14.4 GB | No |
| DeepSeek R1 Distill Llama 70B | 48.0 GB | 14.4 GB | No |
| Hermes 3 Llama 3.1 70B | 48.0 GB | 14.4 GB | No |
| Llama 3.1 70B Instruct | 48.0 GB | 14.4 GB | No |
| Llama 3.3 70B Instruct | 48.0 GB | 14.4 GB | No |
Q4 / Q8 / FP16 overview
Status below is the best calculated result across evaluated context lengths for each quantization. Open a model for the full table.
| Model | Params | Q4 | Q8 | FP16 | Max context in VRAM |
|---|---|---|---|---|---|
| Qwen2.5 0.5B Instruct | 494M | Fits | Fits | Fits | 32K |
| Qwen3 0.6B | 752M | Fits | Fits | Fits | 40K |
| Gemma 3 1B Instruct | 1000M | Fits | Fits | Fits | 32K |
| TinyLlama 1.1B Chat v1.0 | 1.1B | Fits | Fits | Fits | 2K |
| Llama 3.2 1B Instruct | 1.2B | Fits | Fits | Fits | 128K |
| Qwen2.5 1.5B Instruct | 1.5B | Fits | Fits | Fits | 32K |
| Qwen2.5-Coder 1.5B Instruct | 1.5B | Fits | Fits | Fits | 32K |
| Falcon 3 1B Instruct | 1.7B | Fits | Fits | Fits | 8K |
| SmolLM2 1.7B Instruct | 1.7B | Fits | Fits | Fits | 8K |
| DeepSeek R1 Distill Qwen 1.5B | 1.8B | Fits | Fits | Fits | 128K |
| Qwen3 1.7B | 2.0B | Fits | Fits | Fits | 40K |
| Gemma 2 2B Instruct | 2.6B | Fits | Fits | Fits | 8K |
| SmolLM3 3B | 3.1B | Fits | Fits | Fits | 64K |
| Qwen2.5 3B Instruct | 3.1B | Fits | Fits | Fits | 32K |
| Llama 3.2 3B Instruct | 3.2B | Fits | Fits | Fits | 64K |
| Falcon 3 3B Instruct | 3.2B | Fits | Fits | Fits | 32K |
| Phi-3.5 Mini Instruct | 3.8B | Fits | Fits | Fits | 16K |
| Phi-3 Mini 128K Instruct | 3.8B | Fits | Fits | Fits | 16K |
| Phi-3 Mini 4K Instruct | 3.8B | Fits | Fits | Fits | 4K |
| Phi-4 Mini Reasoning | 3.8B | Fits | Fits | Fits | 64K |
| Phi-4 Mini Instruct | 3.8B | Fits | Fits | Fits | 64K |
| Qwen3 4B | 4.0B | Fits | Fits | Fits | 40K |
| Gemma 3 4B Instruct | 4.3B | Fits | Fits | Fits | 64K |
| Gemma 4 E2B Instruct | 5.1B | Fits | Fits | Fits | 128K |
| Code Llama 7B Instruct | 6.7B | Fits | Fits | Offload | 16K |
| Vicuna 7B v1.5 | 6.7B | Fits | Fits | Offload | 4K |
| DeepSeek LLM 7B Chat | 6.9B | Fits | Fits | Offload | 4K |
| OLMoE 1B-7B Instruct | 6.9B | Fits | Fits | Offload | 4K |
| StarCoder2 7B | 7.2B | Fits | Fits | Offload | 16K |
| Falcon 7B Instruct | 7.2B | Fits | Fits | Offload | 16K |
| OpenChat 3.5 7B | 7.2B | Fits | Fits | Offload | 8K |
| Mistral 7B Instruct v0.3 | 7.3B | Fits | Fits | Offload | 32K |
| OLMo 2 7B Instruct | 7.3B | Fits | Fits | Offload | 4K |
| Falcon 3 7B Instruct | 7.5B | Fits | Fits | Offload | 32K |
| DeepSeek R1 Distill Qwen 7B | 7.6B | Fits | Fits | Offload | 128K |
| Qwen2.5 7B Instruct | 7.6B | Fits | Fits | Offload | 32K |
| Qwen2.5-Coder 7B Instruct | 7.6B | Fits | Fits | Offload | 32K |
| Qwen2.5-Math 7B Instruct | 7.6B | Fits | Fits | Offload | 4K |
| Qwen2 7B Instruct | 7.6B | Fits | Fits | Offload | 32K |
| Gemma 4 E4B Instruct | 8.0B | Fits | Fits | Offload | 64K |
| Ministral 8B Instruct | 8.0B | Fits | Fits | Offload | 32K |
| DeepSeek R1 Distill Llama 8B | 8.0B | Fits | Fits | Offload | 64K |
| Hermes 3 Llama 3.1 8B | 8.0B | Fits | Fits | Offload | 64K |
| Llama 3.1 8B Instruct | 8.0B | Fits | Fits | Offload | 64K |
| Llama 3 8B Instruct | 8.0B | Fits | Fits | Offload | 8K |
| Qwen3 8B | 8.2B | Fits | Fits | Offload | 40K |
| Yi 1.5 9B Chat | 8.8B | Fits | Fits | Offload | 4K |
| Gemma 2 9B Instruct | 9.2B | Fits | Fits | Offload | 8K |
| GLM-4-9B-0414 | 9.4B | Fits | Fits | Offload | 32K |
| GLM-4 9B Chat | 9.4B | Fits | Fits | Offload | 8K |
| Falcon 3 10B Instruct | 10B | Fits | Fits | Offload | 32K |
| SOLAR 10.7B Instruct | 11B | Fits | Fits | Offload | 4K |
| Gemma 4 12B Instruct | 12B | Fits | Offload | Offload | 16K |
| Gemma 3 12B Instruct | 12B | Fits | Offload | Offload | 16K |
| Mistral Nemo 12B Instruct | 12B | Fits | Offload | Offload | 32K |
| Code Llama 13B Instruct | 13B | Fits | Offload | Offload | 8K |
| Vicuna 13B v1.5 | 13B | Fits | Offload | Offload | 4K |
| OLMo 2 13B Instruct | 14B | Fits | Offload | Offload | 4K |
| Phi-3 Medium 128K Instruct | 14B | Fits | Offload | Offload | 32K |
| Phi-3 Medium 4K Instruct | 14B | Fits | Offload | Offload | 4K |
| Phi-4 Reasoning | 15B | Fits | Offload | Offload | 16K |
| DeepSeek R1 Distill Qwen 14B | 15B | Fits | Offload | Offload | 32K |
| Phi-4 | 15B | Fits | Offload | Offload | 16K |
| Qwen2.5 14B Instruct | 15B | Fits | Offload | Offload | 32K |
| Qwen3 14B | 15B | Fits | Offload | Offload | 32K |
| StarCoder2 15B | 16B | Fits | Offload | Offload | 16K |
| GPT-OSS 20B | 22B | Offload | Offload | No | 32K |
| Magistral Small | 24B | Offload | Offload | No | 8K |
| Mistral Small 24B Instruct | 24B | Offload | Offload | No | 8K |
| Mistral Small 3.2 24B Instruct | 24B | Offload | Offload | No | 8K |
| Gemma 4 26B-A4B Instruct | 27B | Offload | Offload | No | — |
| Gemma 2 27B Instruct | 27B | Offload | Offload | No | — |
| Gemma 3 27B Instruct | 27B | Offload | Offload | No | — |
| Qwen3-Coder 30B-A3B Instruct | 31B | Offload | Offload | No | — |
| Qwen3 30B-A3B | 31B | Offload | Offload | No | — |
| Gemma 4 31B Instruct | 31B | Offload | Offload | No | — |
| OLMo 2 32B Instruct | 32B | Offload | Offload | No | — |
| DeepSeek R1 Distill Qwen 32B | 33B | Offload | Offload | No | — |
| Qwen2.5 32B Instruct | 33B | Offload | Offload | No | — |
| Qwen2.5-Coder 32B Instruct | 33B | Offload | Offload | No | — |
| QwQ 32B | 33B | Offload | Offload | No | — |
| Qwen3 32B | 33B | Offload | Offload | No | — |
| DeepSeek Coder 33B Instruct | 33B | Offload | Offload | No | — |
| Code Llama 34B Instruct | 34B | Offload | No | No | — |
| Yi 1.5 34B Chat | 34B | Offload | No | No | — |
| Mixtral 8x7B Instruct | 47B | Offload | No | No | — |
| DeepSeek R1 Distill Llama 70B | 71B | No | No | No | — |
| Hermes 3 Llama 3.1 70B | 71B | No | No | No | — |
| Llama 3.1 70B Instruct | 71B | No | No | No | — |
| Llama 3.3 70B Instruct | 71B | No | No | No | — |
| Qwen2.5 72B Instruct | 73B | No | No | No | — |
| GLM-4.5 Air | 110B | No | No | No | — |
| GPT-OSS 120B | 117B | No | No | No | — |
| Mixtral 8x22B Instruct | 141B | No | No | No | — |
| Qwen3 235B-A22B | 235B | No | No | No | — |
| GLM-4.5 | 358B | No | No | No | — |
Available graphics cards
These are Icecat product SKUs mapped to this chip. Different board-partner cards are not assumed to share a price. Amazon CTAs appear only for EXACT/HIGH matches that are not bundled accessories.

GIGABYTE GAMING Radeon RX 7800 XT OC AMD 16 GB GDDR6
16 GB · Amazon EXACT
Check price on Amazon
ASUS Dual -RX7800XT-O16G AMD Radeon RX 7800 XT 16 GB GDDR6
16 GB · Amazon EXACT
Check price on Amazon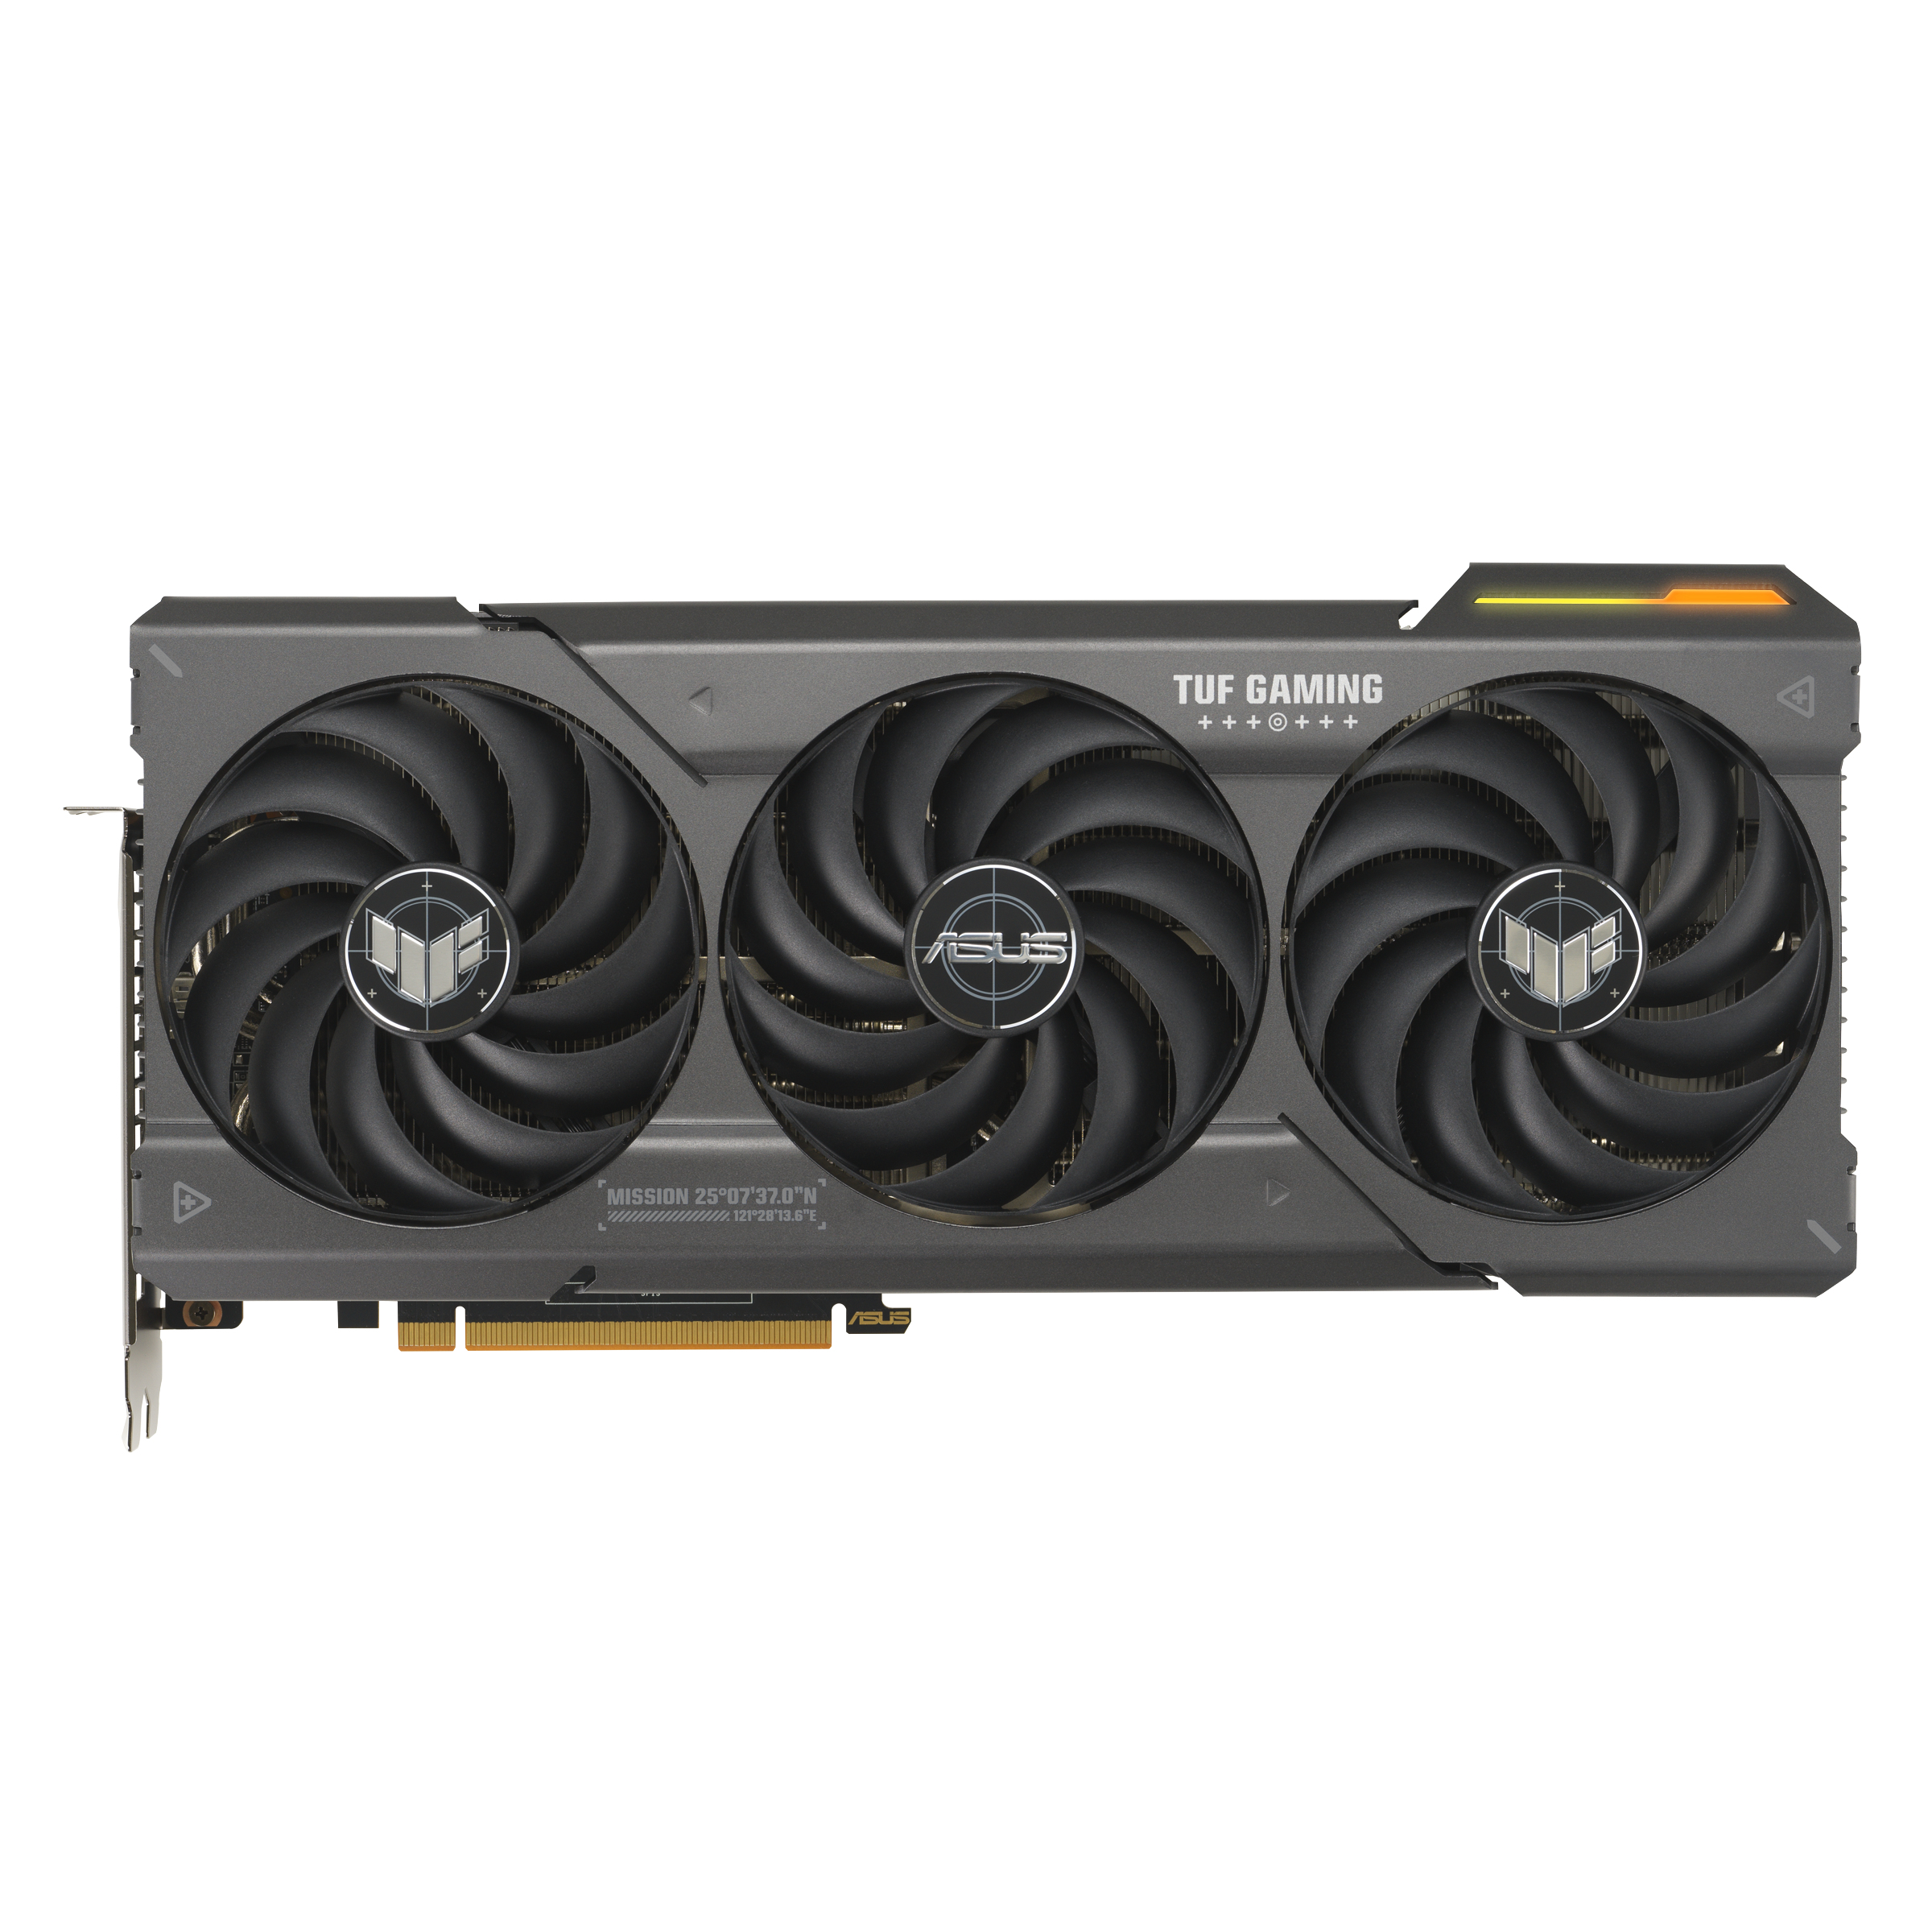
ASUS TUF Gaming TUF-RX7800XT-O16G-GAMING AMD Radeon RX 7800 XT 16 GB GDDR6
16 GB · Amazon unmatched
Sources
GPU identity and VRAM: Icecat structured specifications. Compatibility: RigForAI calculated estimate. Amazon: live affiliate match on individual SKUs, via /go/amazon/.